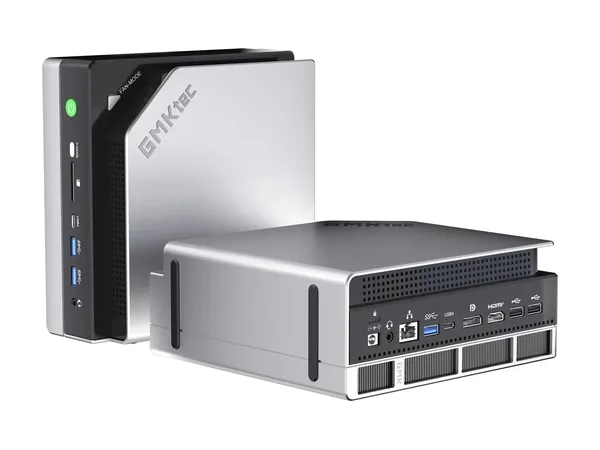
Strix Halo
GMKtec EVO-X2
Ryzen AI Max+ 395, 64GB / 1TB
64 GB of LPDDR5X-8000 unified at 256 GB/s. Runs up to Qwen3.6 35B-A3B, Gemma 4 31B, GLM-4.7-Flash 30B-A3B.
- Memory
- 64 GB ~48 GB usable for models
- Bandwidth
- 256 GB/s sets tokens/sec
- Software
- ROCm ROCm / Vulkan
- Price per GB
- $34.37 of model memory
Where to buy
- GMKtec store $2,200AvailableCheck price at GMKtec
What it runs
Estimated fit and decode speed for one user at ~8K context. How we estimate
- Qwen3.5 9Bdense · 9B active
Q4_K_MFits~28 tok/s7 of 48 GBQ8_0Fits~16 tok/s12 of 48 GB
- Gemma 4 12Bdense · 12B active
Q4_K_MFits~21 tok/s9 of 48 GBQ8_0Fits~12 tok/s15 of 48 GB
- GPT-OSS 20BMoE · 3.6B active
MXFP4 (native)Fits~80 tok/s13 of 48 GBQ8_0Fits~40 tok/s25 of 48 GB
- Gemma 4 26B-A4BMoE · 3.8B active
Q4_K_MFits~67 tok/s18 of 48 GBQ8_0Fits~38 tok/s30 of 48 GB
- Qwen3.8 27Bdense · 27B active
Q4_K_MFits~9 tok/s19 of 48 GBQ8_0Fits~5 tok/s32 of 48 GB
- GLM-4.7-Flash 30B-A3BMoE · 3B active
Q4_K_MFits~84 tok/s21 of 48 GBQ8_0Fits~48 tok/s35 of 48 GB
- Gemma 4 31Bdense · 31B active
Q4_K_MFits~8 tok/s21 of 48 GBQ8_0Fits~5 tok/s36 of 48 GB
- Qwen3.6 35B-A3BMoE · 3B active
Q4_K_MFits~84 tok/s24 of 48 GBQ8_0Fits~48 tok/s41 of 48 GB
- Llama 3.3 70Bdense · 70B active
Q4_K_MTight fit~4 tok/s46 of 48 GBQ8_0Won't fitneeds ~80 GB
- Qwen3-Next 80B-A3BMoE · 3B active
Q4_K_MWon't fitneeds ~52 GBQ8_0Won't fitneeds ~91 GB
- Llama 4 Scout 109B-A17BMoE · 17B active
Q4_K_MWon't fitneeds ~71 GBQ8_0Won't fitneeds ~123 GB
- GPT-OSS 120BMoE · 5.1B active
MXFP4 (native)Won't fitneeds ~67 GBQ8_0Won't fitneeds ~132 GB
- Nemotron 3 Super 120B-A12BMoE · 12B active
Q4_K_MWon't fitneeds ~78 GBQ8_0Won't fitneeds ~135 GB
- Qwen3.5 122B-A10BMoE · 10B active
Q4_K_MWon't fitneeds ~79 GBQ8_0Won't fitneeds ~138 GB
- Qwen3 235B-A22BMoE · 22B active
Q4_K_MWon't fitneeds ~151 GBQ8_0Won't fitneeds ~264 GB
- Muse Spark Open 816B-A42BMoE · 42B active
Q4_K_MWon't fitneeds ~521 GBQ8_0Won't fitneeds ~912 GB
Image: GMKtec store product image